Cloud chậm chưa chắc vì thiếu tài nguyên: 7 điểm cần kiểm tra trước khi nâng cấu hình
Cloud chậm không đồng nghĩa doanh nghiệp đang thiếu CPU hoặc RAM. Bottleneck có thể nằm ở workload, storage IOPS, network, database, cấu hình ứng dụng hoặc contention. Trước khi nâng cấu hình, nên kiểm tra theo một trình tự chẩn đoán để tránh tăng chi phí nhưng không giải quyết đúng nguyên nhân.
Dấu hiệu Cloud đang bị chậm
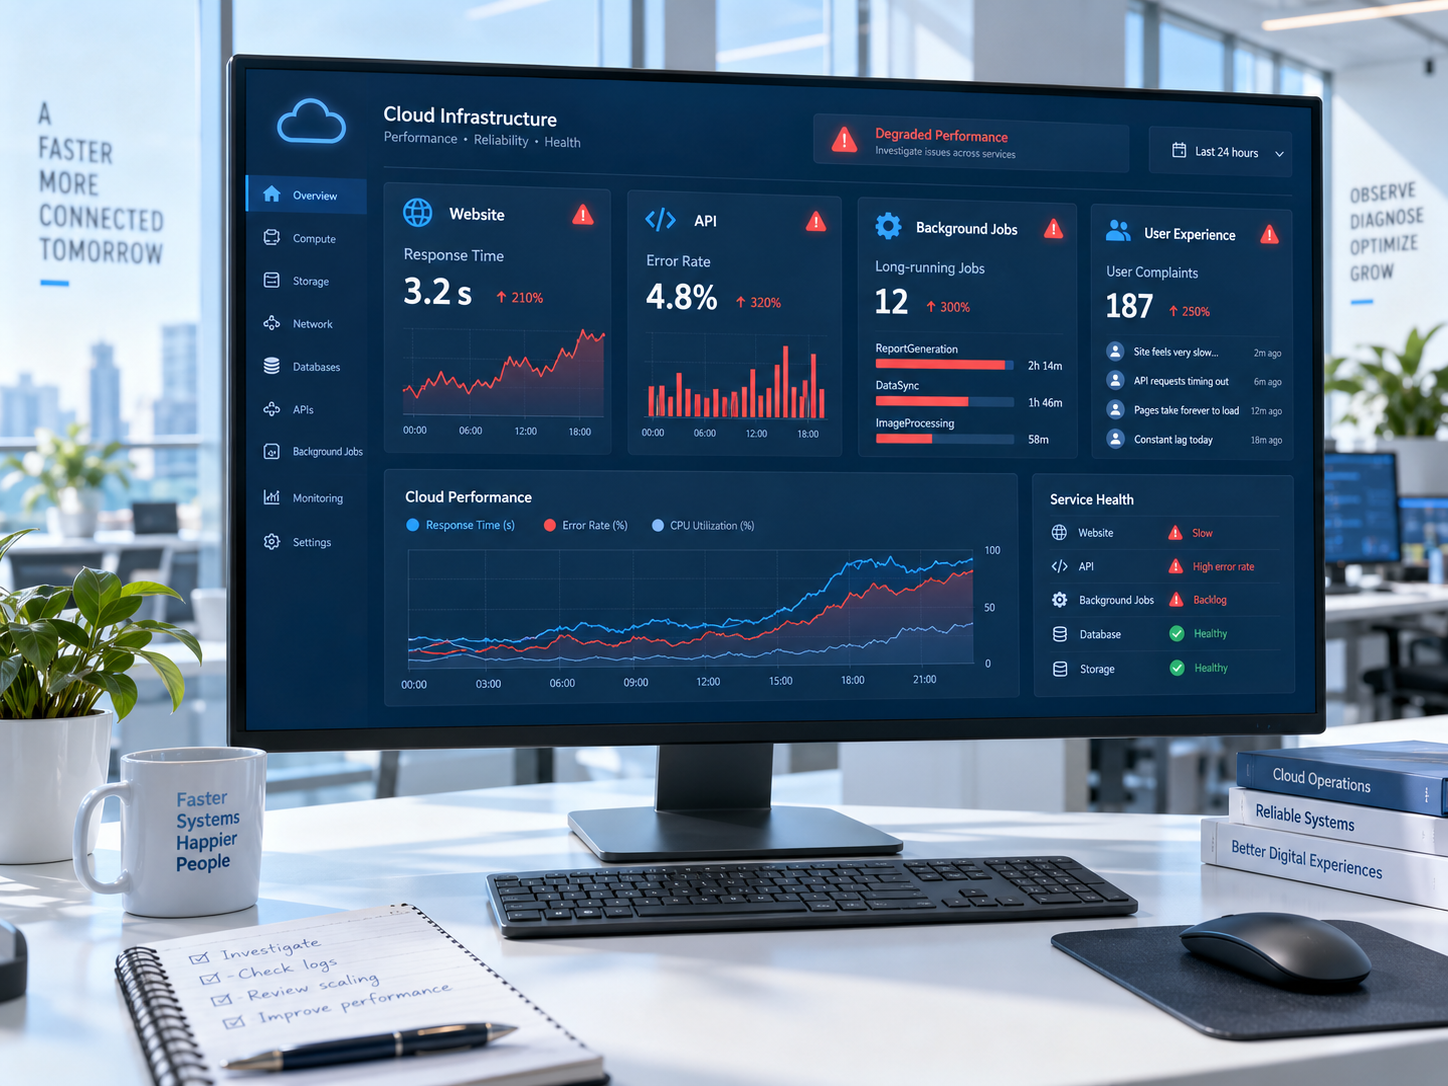
Trước khi đi vào chẩn đoán kỹ thuật, cần xác định các dấu hiệu mà người dùng cuối và hệ thống đang ghi nhận. Các biểu hiện phổ biến bao gồm:
-
Thời gian phản hồi ứng dụng (Response Time) cao: Website, API hoặc ứng dụng nội bộ mất nhiều thời gian hơn bình thường để tải hoặc xử lý một tác vụ.
-
Tỷ lệ lỗi (Error Rate) tăng: Hệ thống ghi nhận nhiều lỗi timeout, 5xx server errors hoặc các lỗi liên quan đến kết nối cơ sở dữ liệu.
-
Các tác vụ nền (Background Jobs) chạy lâu hơn: Các công việc xử lý theo lô, xuất báo cáo, hoặc đồng bộ dữ liệu mất nhiều thời gian hơn đáng kể so với trước đây.
-
Phản hồi từ người dùng cuối: Người dùng phàn nàn về trải nghiệm giật, lag, hoặc phải chờ đợi lâu khi tương tác với dịch vụ.
Gợi ý 7 điểm cần kiểm tra khi có các dấu hiệu chậm
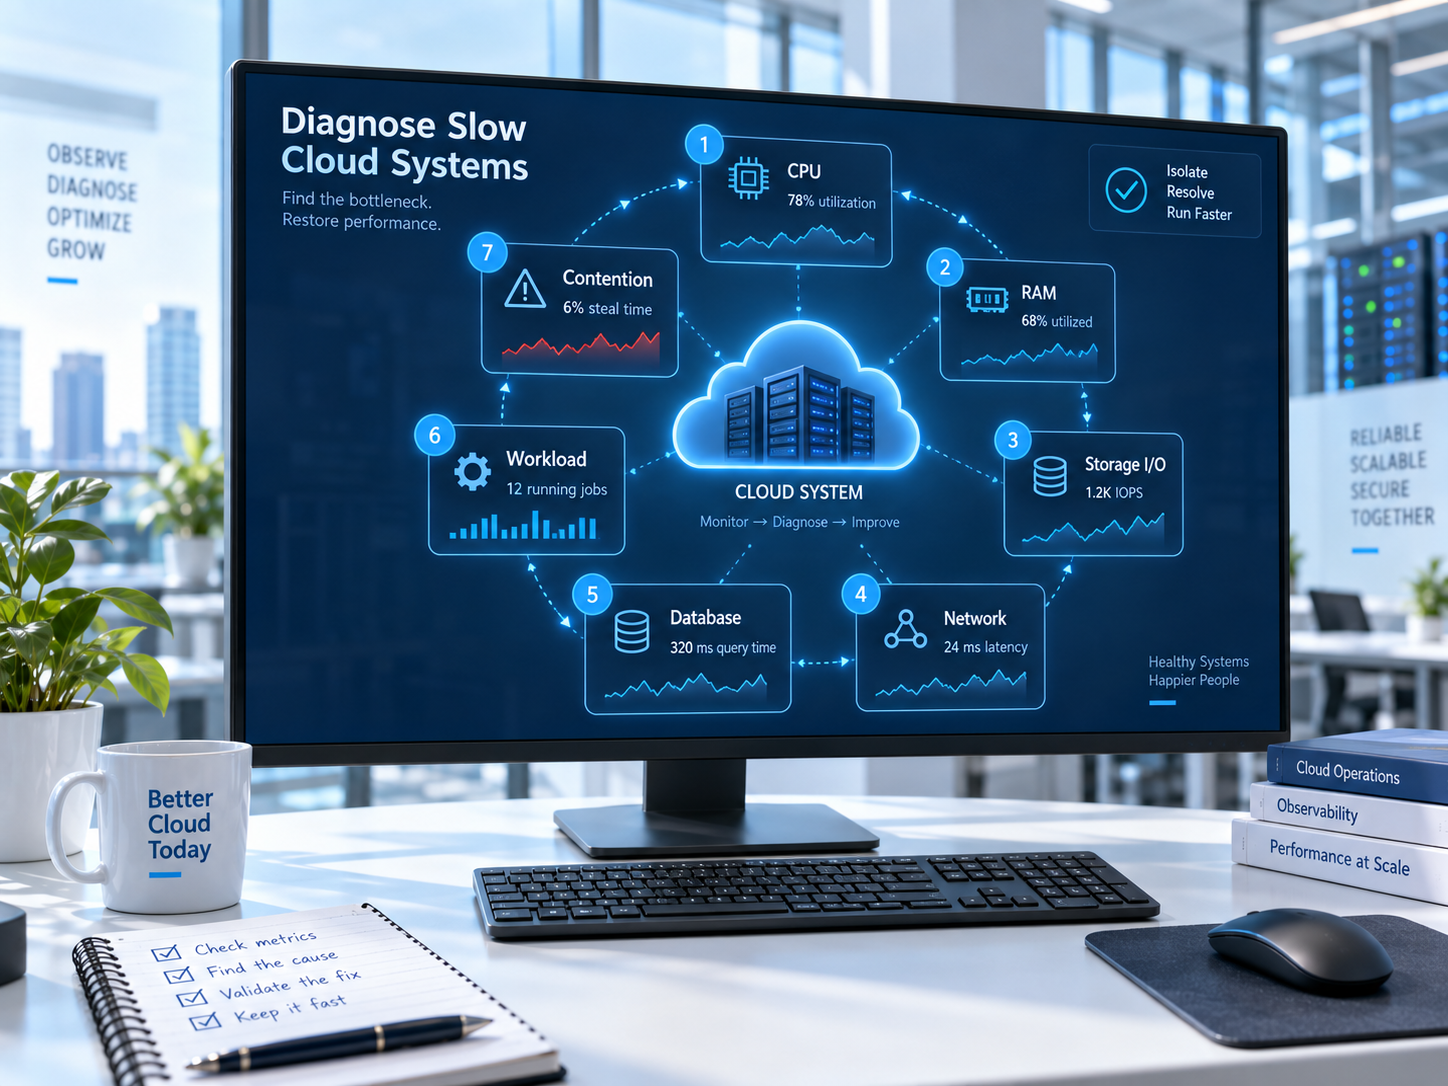
Khi đã xác nhận các dấu hiệu trên, IT Manager hoặc CIO cần tiếp cận vấn đề một cách có hệ thống. Dưới đây là 7 điểm trọng yếu cần kiểm tra để xác định chính xác bottleneck, được trình bày dưới dạng một decision tree chẩn đoán.
|
Tiêu chí kiểm tra |
Chỉ số cần theo dõi |
Gợi ý nguyên nhân |
|---|---|---|
|
1. CPU |
CPU Utilization (%), CPU Steal Time (%), Load Average |
Workload quá tải, ứng dụng sử dụng tài nguyên không hiệu quả, hoặc “noisy neighbor” trên hạ tầng ảo hóa. |
|
2. RAM |
Memory Usage (%), Swap Usage |
Thiếu RAM vật lý, ứng dụng bị rò rỉ bộ nhớ (memory leak), cấu hình cache chưa tối ưu. |
|
3. Storage I/O |
IOPS (Input/Output Operations Per Second), Read/Write Latency (ms), Disk Queue Length |
Loại storage (SSD/HDD) không phù hợp với workload, đạt giới hạn IOPS của gói dịch vụ, hoạt động đọc/ghi quá lớn. |
|
4. Network |
Network Throughput (Mbps), Latency (ms), Packet Loss (%) |
Tắc nghẽn băng thông, cấu hình firewall/security group chưa tối ưu, vấn đề định tuyến hoặc hạ tầng mạng của nhà cung cấp. |
|
5. Database |
Query Execution Time, Number of Connections, Index Hit Rate, Deadlocks |
Câu lệnh truy vấn (query) không được tối ưu, thiếu chỉ mục (index), xung đột tài nguyên (lock/deadlock). |
|
6. Workload ứng dụng |
Requests Per Second (RPS), Response Time trên từng thành phần |
Code xử lý không hiệu quả, logic nghiệp vụ phức tạp, tăng trưởng người dùng đột biến mà kiến trúc chưa đáp ứng kịp. |
|
7. Contention (Tranh chấp tài nguyên) |
CPU Steal Time (%) |
Trong môi trường ảo hóa, máy ảo của bạn phải chờ đợi tài nguyên CPU vật lý vì các máy ảo khác đang sử dụng quá mức. |
Cách đọc các tín hiệu
Việc thu thập các chỉ số trên chỉ là bước đầu. Quan trọng hơn là cách diễn giải chúng để tìm ra nguyên nhân gốc rễ:
-
CPU Utilization cao liên tục (> 80-90%): Đây là dấu hiệu rõ ràng của việc thiếu tài nguyên xử lý. Tuy nhiên, nếu chỉ số này cao nhưng Load Average vẫn thấp, vấn đề có thể nằm ở một tiến trình đơn luồng (single-threaded) đang chiếm dụng toàn bộ một core.
-
Swap Usage tăng: Khi RAM vật lý cạn kiệt, hệ điều hành sẽ sử dụng một phần ổ cứng làm RAM ảo (swap). Đây là một tín hiệu mạnh cho thấy hệ thống đang thiếu RAM, vì tốc độ của swap chậm hơn RAM rất nhiều.
-
Disk Latency cao: Độ trễ đọc/ghi ổ đĩa cao, dù IOPS chưa tới giới hạn, cho thấy loại storage hiện tại không đáp ứng được yêu cầu về tốc độ của ứng dụng.
-
Packet Loss: Tỷ lệ mất gói tin dù chỉ 1% cũng có thể làm giảm đáng kể hiệu năng của các ứng dụng dựa trên giao thức TCP, gây ra việc truyền lại dữ liệu và tăng độ trễ.
Khi nào nên scale?
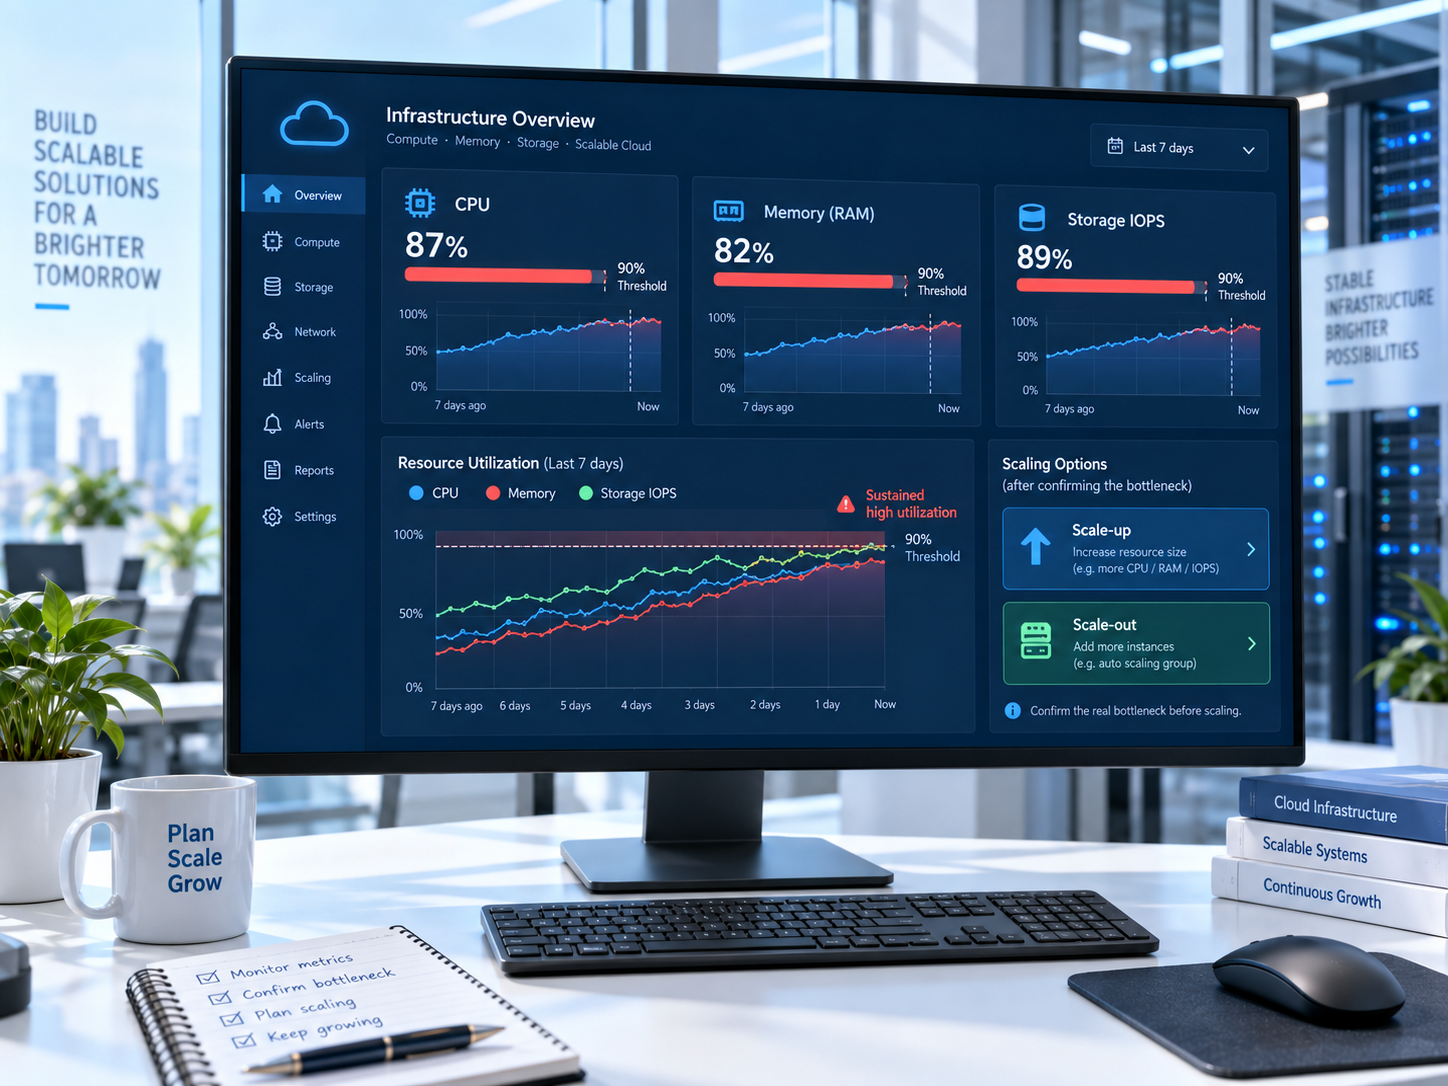
Nâng cấp cấu hình (scale-up) hoặc tăng số lượng server (scale-out) là cần thiết khi và chỉ khi bạn đã xác định rõ bottleneck nằm ở tài nguyên hạ tầng và không thể giải quyết bằng cách tối ưu phần mềm.
-
Tài nguyên đạt ngưỡng bền vững: Các chỉ số như CPU, RAM, IOPS liên tục ở mức cao trong thời gian dài, không phải là các đỉnh nhọn tạm thời.
-
Đã loại trừ các nguyên nhân khác: Đã kiểm tra và chắc chắn rằng vấn đề không đến từ database query chậm, code không hiệu quả hay cấu hình sai.
-
Dự báo tăng trưởng: Doanh nghiệp có kế hoạch cho một chiến dịch marketing lớn hoặc dự báo lượng người dùng sẽ tăng đột biến.
Khi cần mở rộng tài nguyên một cách linh hoạt, các giải pháp như StarCloud Elastic Compute cho phép điều chỉnh cấu hình CPU và RAM để đáp ứng nhu cầu tức thời.
Khi nào cần tối ưu ứng dụng?
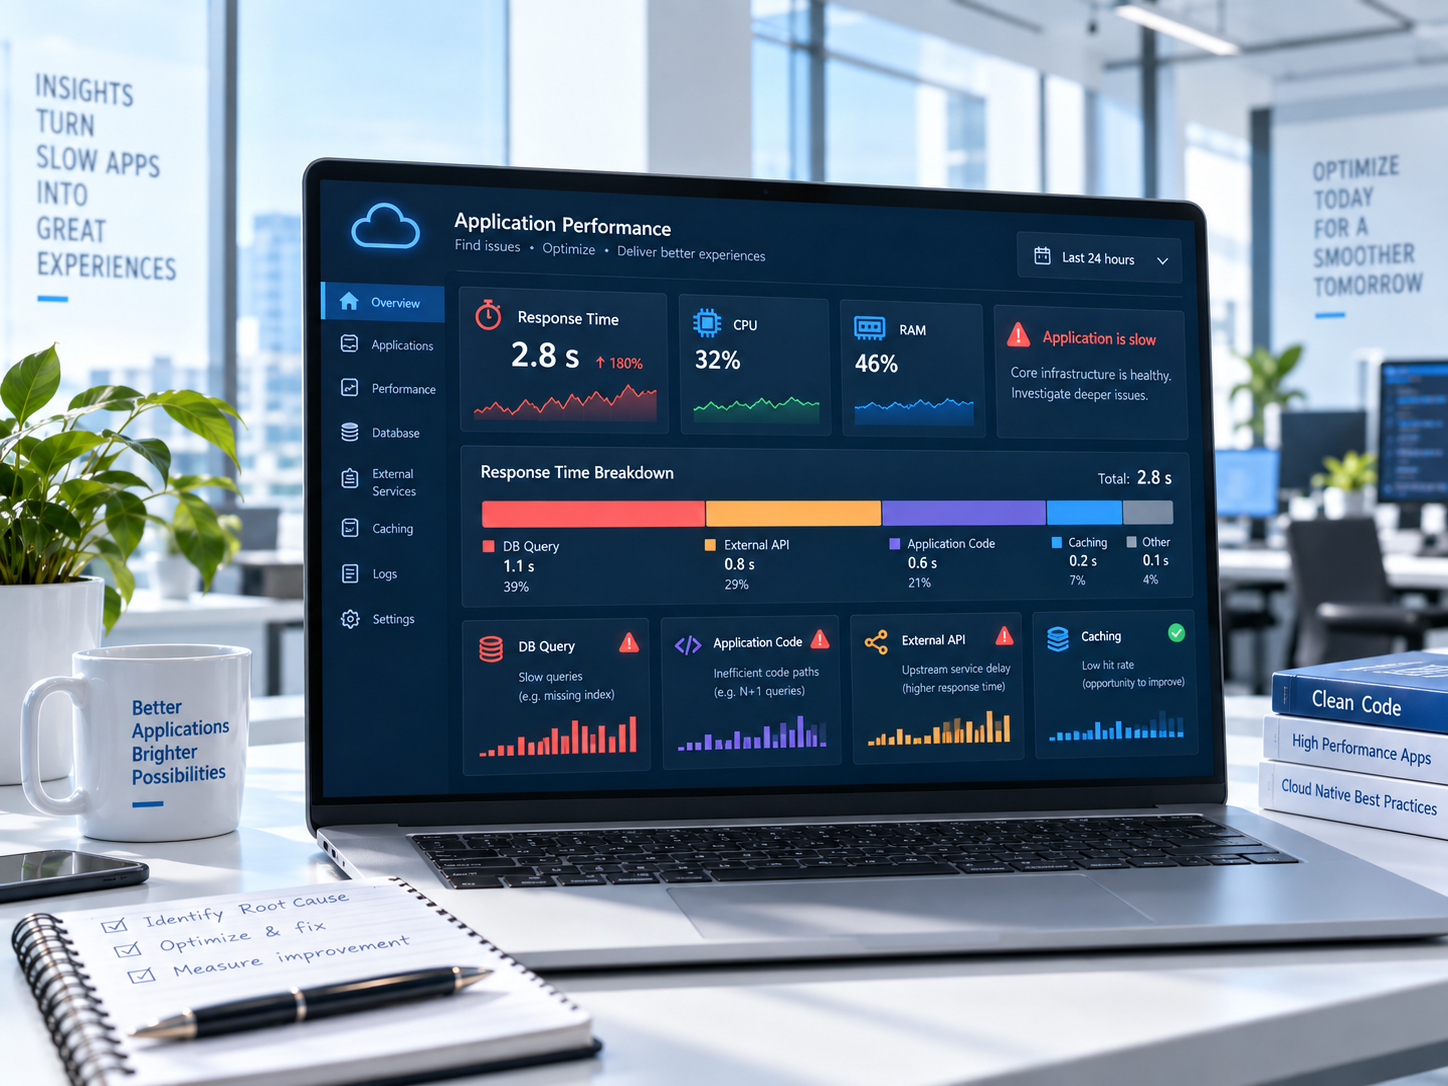
Trong nhiều trường hợp, giải pháp không phải là chi thêm tiền cho phần cứng mà là cải thiện hiệu quả của phần mềm. Hãy cân nhắc tối ưu ứng dụng khi:
-
Tài nguyên còn dư thừa nhưng hệ thống vẫn chậm: CPU và RAM ở mức thấp nhưng response time của ứng dụng vẫn cao. Đây là dấu hiệu của việc chờ đợi một tài nguyên khác (ví dụ: API bên ngoài, database query).
-
Phân tích cho thấy code không hiệu quả: Các công cụ profiling chỉ ra những hàm hoặc câu lệnh truy vấn chiếm phần lớn thời gian xử lý.
-
Có thể áp dụng Caching: Nhiều dữ liệu có thể được lưu vào bộ nhớ đệm (cache) để giảm tải cho database và tăng tốc độ phản hồi.
Việc tối ưu hóa hạ tầng và ứng dụng trên cloud có thể giúp giảm chi phí vận hành và cải thiện hiệu năng mà không cần nâng cấp tài nguyên.
Gợi ý các bước hành động tiếp theo
Chẩn đoán hiệu năng Cloud là một quá trình đòi hỏi phương pháp luận và công cụ phù hợp. Thay vì vội vàng tăng cấu hình, việc kiểm tra có hệ thống theo 7 điểm trên sẽ giúp doanh nghiệp xác định đúng nguyên nhân và đưa ra quyết định đầu tư hiệu quả. Việc này không chỉ tiết kiệm chi phí mà còn đảm bảo sự ổn định và hiệu suất bền vững cho hệ thống.
Nếu bạn cần hỗ trợ chuyên sâu để chẩn đoán và khắc phục tình trạng Cloud chậm, hãy Liên hệ / để lại thông tin liên hệ để các chuyên gia của SV Telecom cùng bạn phân tích hiện trạng và đề xuất giải pháp phù hợp.